Business Strategy & Growth

August 11, 2026

10 min leestijd
AI-projecten beginnen vaak met vragen over modellen, leveranciers, architectuur en use cases:
Die vragen zijn belangrijk, maar misschien komen ze te vroeg. Voor u beslist hoe u een AI-oplossing gaat bouwen, moet eerst een fundamentelere vraag worden beantwoord: Kan uw data deze oplossing veilig en betrouwbaar ondersteunen?
Veel problemen die later als “AI-problemen” worden gezien, zijn in werkelijkheid dataproblemen die al lang vóór het AI-project bestonden. Slechte datakwaliteit, gefragmenteerde systemen, onduidelijk eigenaarschap, zwakke toegangsrechten, privacybeperkingen, historische bias en verouderde documentatie kunnen allemaal aanzienlijk duurder worden zodra er een model, integraties en productieprocessen rond gebouwd zijn.
Daarom zou AI-readiness moeten beginnen met een data risk review. Het doel is niet om uw data perfect te maken. Het gaat erom zwakke punten te identificeren die de geplande AI-oplossing onbetrouwbaar, onveilig, niet-compliant, onverwacht duur of moeilijk te beheren kunnen maken vóór de ontwikkeling start.
Het eerste risico is ook het meest fundamentele: datakwaliteit. Een AI-systeem kan alleen werken met de informatie die beschikbaar is. Als die informatie onjuist, onvolledig, gedupliceerd, inconsistent of verouderd is, kan AI die problemen op grote schaal reproduceren.
Typische waarschuwingssignalen zijn:
Bij traditionele software kan slechte data leiden tot een fout dashboard of een onvolledig rapport.
Bij AI is het probleem soms moeilijker te herkennen, omdat de output alsnog overtuigend kan klinken.
Een customer-supportassistent kan bijvoorbeeld een perfect geformuleerd antwoord genereren op basis van een verouderd beleidsdocument. Een forecastingmodel kan technisch correct functioneren terwijl het steunt op inconsistente historische data. Een AI-salesassistent kan de verkeerde vervolgstap adviseren omdat CRM-velden onvolledig zijn.
De pre-build-vraag is daarom niet alleen: Hebben we data? De echte vraag is: Is deze data voldoende accuraat, compleet, actueel en consistent voor deze specifieke use case?
Organisaties ontdekken vaak dat de benodigde informatie wel bestaat, maar verspreid is over meerdere systemen.
Eén AI-use case kan bijvoorbeeld afhankelijk zijn van informatie uit:
Dat creëert een verborgen scoperisico. Wat aanvankelijk een AI-developmentproject lijkt, kan snel veranderen in een data-integratieproject met API’s, migraties, transformaties, identity management, datapipelines en beperkingen van legacysystemen. Dat komt vooral vaak voor bij enterprise AI-assistenten.
Een bedrijf kan zeggen: “We willen een AI-assistent die al onze klantinformatie begrijpt.”
De volgende vraag zou moeten zijn: Waar staat die informatie daadwerkelijk, en kunnen we die betrouwbaar verbinden?
Als klantcontracten in het ene systeem staan, prijzen in een ander, supporthistorie in een derde en accountstatussen in handmatig bijgehouden spreadsheets, kan de integratie-inspanning groter worden dan de implementatie van het model zelf.
Breng vóór de build de databronnen, afhankelijkheden, eigenaars, updatefrequenties en toegangsvereisten in kaart. Die oefening kan de architectuur, timing en businesscase aanzienlijk veranderen.
Een andere veelgemaakte fout is aannemen dat veel historische data automatisch betekent dat een organisatie AI-ready is.
Volume en representativiteit zijn niet hetzelfde.
Een dataset kan miljoenen records bevatten en toch bepaalde groepen slecht vertegenwoordigen, zoals:
Dat is belangrijk omdat een AI-systeem leert van de werkelijkheid die in de data wordt weergegeven, niet noodzakelijk van de werkelijkheid waarin het uiteindelijk zal opereren.
Stel dat een AI-supportsysteem voornamelijk is getraind op Engelstalige gesprekken. De gemiddelde performance kan tijdens evaluatie sterk lijken, terwijl de prestaties voor Nederlandstalige of Franstalige klanten aanzienlijk slechter zijn.
Hetzelfde geldt voor predictive systems. Een model kan een hoge gemiddelde nauwkeurigheid behalen en toch slecht presteren voor een commercieel belangrijke klantgroep of een ongebruikelijk operationeel scenario.
Vraag vóór ontwikkeling daarom: Vertegenwoordigt onze data de klanten, situaties, talen en omgevingen waarmee de AI in de praktijk te maken krijgt?
Kijk daarbij niet alleen naar gemiddelde modelperformance. Belangrijke verschillen kunnen verdwijnen achter één headline accuracy-cijfer.
Historische bedrijfsdata wordt vaak behandeld als objectieve waarheid. Maar data bevat de uitkomsten van eerdere bedrijfsprocessen, beslissingen, incentives, beleidsregels en menselijke beoordelingen.
Als die processen bias of inconsistenties bevatten, kan een AI-systeem die leren en opschalen.
Denk aan labels zoals:
Ze lijken misschien feitelijke categorieën in een database, maar weerspiegelen vaak menselijke beslissingen of eerdere businessregels.
De vraag is daarom niet alleen of de dataset technisch schoon is.
De belangrijkere vraag is: Welke historische patronen willen we daadwerkelijk door AI laten reproduceren?
Er is ook het risico van proxyvariabelen. Het verwijderen van een duidelijke gevoelige eigenschap verwijdert bias niet automatisch als andere variabelen er indirect mee correleren. Locatie, opleiding, werkverleden, inkomensindicatoren of koopgedrag kunnen onbedoeld opnieuw onderscheid creëren dat de organisatie niet wilde maken.
Bias assessment moet daarom al tijdens datavoorbereiding plaatsvinden en niet pas nadat het model is getraind.
AI-projecten werken vaak met persoonlijke of gevoelige informatie. Klantgesprekken, personeelsgegevens, supporttickets, gedragsdata, documenten, financiële informatie en transactiehistorie kunnen allemaal persoonsgegevens bevatten.
Voor Europese organisaties leidt dat direct tot GDPR-overwegingen.
Voor deze data aan een AI-systeem wordt gekoppeld, moeten organisaties vaststellen:
Hier kan een technisch eenvoudig AI-idee snel veranderen in een compliancevraagstuk. Een bedrijf kan bijvoorbeeld duizenden klantgesprekken in een supportplatform hebben opgeslagen. Dat betekent niet automatisch dat die gesprekken voor elk mogelijk AI-trainings- of analyticsdoel mogen worden hergebruikt.
De nuttige pre-build-vraag is: Kunnen we deze data technisch gebruiken, en mogen we deze data daadwerkelijk op deze manier gebruiken?
Dat zijn twee verschillende vragen.
De EU AI Act voegt voor bepaalde AI-use cases nog een extra laag toe, vooral wanneer systemen in hogere risicocategorieën vallen. Afhankelijk van de toepassing kunnen vereisten rond governance, documentatie, transparantie en datakwaliteit rechtstreeks invloed hebben op hoe het systeem moet worden ontworpen.
Compliance moet daarom worden meegenomen voordat architectuurkeuzes moeilijk terug te draaien zijn.
Security is een ander gebied waar AI-projecten bestaande risico’s in de onderliggende dataomgeving zichtbaar kunnen maken.
Denk aan een interne AI-assistent die gekoppeld wordt aan bedrijfsdocumenten. De eerste requirement klinkt misschien eenvoudig: “Laat medewerkers onze interne kennis doorzoeken met natuurlijke taal.”
Maar daarmee ontstaat een veel belangrijkere vraag: Moet elke medewerker elk document kunnen doorzoeken?
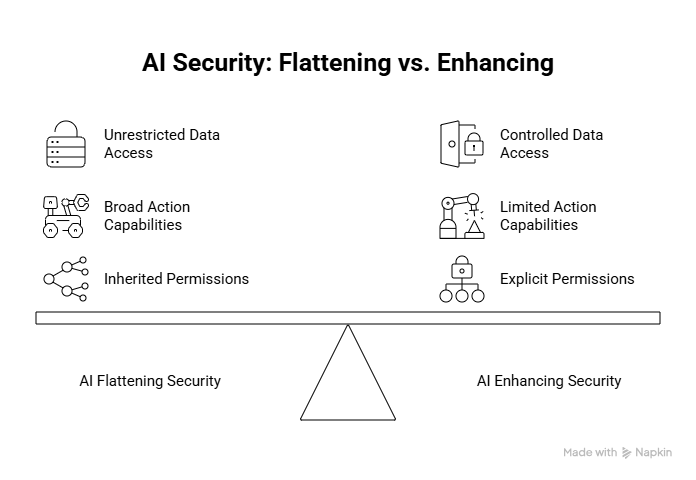
Als HR-, Finance-, Legal-, Sales- en managementdocumenten in één retrievalsysteem terechtkomen zonder de bestaande autorisatieregels te behouden, kan AI in feite securitygrenzen wegvagen die eerder door afzonderlijke applicaties werden afgedwongen.
Een veiliger conceptueel model is:
Gebruiker → identiteit → autorisatie → toegestane data → retrieval → model → antwoord
in plaats van:
Gebruiker → AI → volledige bedrijfskennisbank
Hetzelfde principe geldt voor AI-agents die acties kunnen uitvoeren. Als een AI-systeem CRM-records kan aanpassen, berichten kan versturen, interne databases kan raadplegen, workflows kan goedkeuren of API’s kan activeren, wordt toegangscontrole nog belangrijker.
Bepaal vóór ontwikkeling:
Het kernprincipe moet least privilege zijn: Geef AI alleen de toegang die het daadwerkelijk nodig heeft.
Data provenance en lineage worden steeds belangrijker naarmate AI-architecturen complexer worden. Een AI-systeem kan afhankelijk zijn van informatie die meerdere stappen heeft doorlopen: bronapplicatie → datapipeline → transformatie → warehouse → embedding → retrievalsysteem → model
Als het uiteindelijke antwoord fout is, kunt u het probleem dan terug traceren?
Kunt u bepalen:
Zonder die traceability wordt het veel moeilijker om AI-output te debuggen. Het kan ook compliance- en governanceproblemen veroorzaken, vooral wanneer third-partydatasets of externe informatiebronnen worden gebruikt. De mogelijkheid om te antwoorden op “Waar kwam deze informatie vandaan?” moet daarom vanaf het begin in het systeem worden ontworpen en niet pas later worden toegevoegd.
Een succesvolle eerste datareview betekent niet dat het risico daarna verdwijnt.
Businessdata verandert. Klanten gedragen zich anders. Producten evolueren. Beleidsregels worden vervangen. Nieuwe regio’s worden toegevoegd. Datapipelines veranderen. Documenten raken verouderd.
Dat kan leiden tot data drift of een steeds grotere kloof tussen de informatie die tijdens ontwikkeling werd gebruikt en de omgeving waarin het systeem nu opereert.
Een model dat bij de lancering goed presteerde, kan later minder betrouwbaar worden zonder dat het model zelf veranderd is.
Voor AI in productie hebben organisaties daarom processen nodig voor:
Deployment is niet het einde van data governance. Het is het begin van een nieuwe fase.
Een pre-build datareview hoeft geen governanceprogramma van zes maanden te worden.
Het doel is veel eenvoudiger: identificeer de dataproblemen die de haalbaarheid, het risico, de kosten, de architectuur of de verwachte uitkomst van het AI-project wezenlijk kunnen veranderen vóór er significant developmentbudget wordt vastgelegd.
Een praktische review kan worden opgebouwd rond zes vragen:
Is ze voldoende accuraat, compleet, actueel en consistent?
Kunnen de noodzakelijke bronnen daadwerkelijk worden gekoppeld zonder onverwachte integratie- of infrastructuurwerkzaamheden?
Dekt de data de gebruikers, scenario’s, talen en edge cases waarmee AI te maken krijgt?
Zijn privacy-, security-, contractuele, regelgevende en toegangsvereisten duidelijk?
Zijn eigenaarschap, definities, provenance, metadata en authoritative sources duidelijk?
Kan de organisatie kwaliteit monitoren, informatie bijwerken, toegang beheren en fouten corrigeren na deployment?
De uitkomst hoeft niet altijd “go” te zijn.
Soms is de juiste volgende stap: AI-development → doorgaan
Maar soms moet de volgorde zijn: data cleanup → integratie → governance → AI
En soms laat de review zien dat de use case zelf moet veranderen.
Dat is geen mislukking van het AI-initiatief. Het is precies wat een risk assessment hoort bloot te leggen.
AI creëert druk om snel te bewegen. Een prototype kan vaak binnen dagen of weken worden gebouwd, waardoor het verleidelijk is om bij het model te beginnen en dataproblemen later op te lossen.
Maar een werkend prototype bewijst niet dat een systeem op schaal betrouwbaar kan functioneren. Het grotere risico is dat u zich al vastlegt op een model, architectuur, vendor, budget en deliveryplan voordat u begrijpt of de onderliggende data die keuzes überhaupt kan ondersteunen. Vraag daarom vóór “Welke AI moeten we bouwen?” eerst: “Wat moet waar zijn over onze data voordat deze AI veilig en betrouwbaar kan werken?”
Die vraag kan blootleggen welk werk eerst nodig is. En dat vóór de build ontdekken is bijna altijd goedkoper dan erna.
AI-datareadiness is het proces waarbij wordt beoordeeld of uw data accuraat, toegankelijk, veilig, goed beheerd en geschikt is voor de beoogde AI-use case voordat ontwikkeling start.
Slechte datakwaliteit voor AI kan leiden tot onbetrouwbare output, verborgen bias, zwakke voorspellingen en kostbaar herstelwerk. AI-systemen zijn afhankelijk van de kwaliteit en relevantie van de data die ze gebruiken.
Veelvoorkomende datarisico’s bij AI zijn slechte datakwaliteit, gefragmenteerde systemen, onduidelijk eigenaarschap, privacyproblemen, security gaps, bias, zwakke documentatie en verouderde of niet-representatieve data.
Een AI-datareadiness assessment moet onder andere datakwaliteit, beschikbaarheid, integratiebehoeften, privacy, security, toegangscontrole, bias, governance, documentatie en doorlopend dataonderhoud beoordelen.
Sterke AI data governance helpt bepalen wie eigenaar is van data, welke bronnen authoritative zijn, wie er toegang toe heeft en hoe datakwaliteit, privacy en compliance doorlopend worden beheerd.
Bedrijven kunnen AI-datarisico beperken door vóór de build de benodigde datasets te beoordelen, kritieke gaps te identificeren, compliance- en securityvereisten te valideren en te bepalen of data remediation nodig is voordat AI-development start.